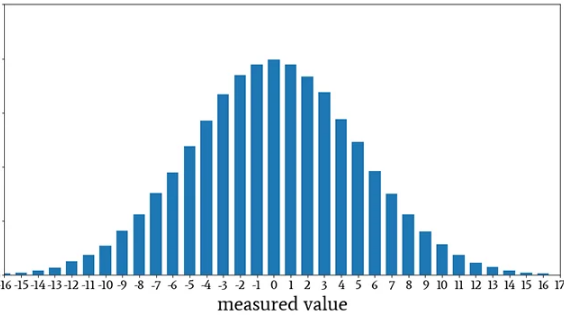
Normal, Rectangular, Triangular… Apa lagi ini… Mungkin itu pengalaman sebagian besar dari kita ketika menghitung ketidakpastian pengukuran.
Ketika pertama kali belajar mengenai measurement uncertainty atau ketidakpastian pengukuran, kita biasanya berhadapan dengan banyak istilah sekaligus: Type A, Type B, standard uncertainty, probability distribution, standard deviation, coverage factor, expanded uncertainty, dan uncertainty budget.
Semuanya terlihat seperti bagian-bagian yang terpisah, Padahal sebenarnya ada hubungan yang cukup sederhana:
Setiap sumber ketidakpastian mempunyai informasi tertentu mengenai kemungkinan nilai yang dapat terjadi. Informasi tersebut dapat dimodelkan menggunakan distribusi probabilitas, kemudian diubah menjadi standard uncertainty sehingga berbagai sumber ketidakpastian dapat digabungkan secara konsisten.
Di sinilah distribusi probabilitas menjadi penting.
Misalnya kita mempunyai sebuah timbangan dengan resolusi 0,01 g. Angka yang ditampilkan adalah:
100,00 g
Apakah benda tersebut sebenarnya tepat 100,00 g?
Belum tentu.
Nilai sebenarnya bisa saja sedikit lebih besar atau sedikit lebih kecil. Jika timbangan membulatkan hasil ke resolusi 0,01 g, kita mempunyai keterbatasan pengetahuan mengenai nilai sebenarnya.
Pertanyaannya kemudian:
Bagaimana kita menggambarkan ketidaktahuan tersebut secara matematis?
Salah satu caranya adalah menggunakan probability distribution atau distribusi probabilitas.
Nah di artikel ini kita akan belajar bareng..
1. Apa Itu Distribusi Probabilitas?
Secara sederhana, distribusi probabilitas adalah cara untuk menggambarkan:
Seberapa besar kemungkinan suatu nilai terjadi dibandingkan dengan nilai lainnya.
Sebagai contoh, kita kembali ke pelajaran SMA, bayangkan kita melempar sebuah dadu.
Untuk dadu yang normal, kemungkinan muncul angka 1, 2, 3, 4, 5, atau 6 adalah sama.
| Nilai | Probabilitas |
|---|---|
| 1 | 1/6 |
| 2 | 1/6 |
| 3 | 1/6 |
| 4 | 1/6 |
| 5 | 1/6 |
| 6 | 1/6 |
Tidak ada angka yang lebih mungkin muncul dibandingkan angka lainnya.
Dalam konteks pengukuran, kondisinya bisa berbeda.
Misalnya kita mengetahui bahwa kesalahan suatu sumber ketidakpastian berada antara:
−1 sampai +1
tetapi kita tidak mempunyai alasan untuk mengatakan bahwa nilai tertentu lebih mungkin daripada nilai lainnya.
Dalam kondisi seperti ini, kita dapat menggunakan rectangular distribution.
Sebaliknya, jika kita mempunyai alasan bahwa nilai yang mendekati tengah lebih mungkin terjadi daripada nilai yang mendekati batas, kita dapat menggunakan triangular distribution.
Jadi, distribusi probabilitas sebenarnya merupakan cara untuk menerjemahkan:
“Apa yang kita ketahui mengenai kemungkinan nilai sebenarnya?”
ke dalam bentuk matematis.
2. Mengapa Distribusi Probabilitas Penting dalam Ketidakpastian?
Ini merupakan pertanyaan yang sangat penting.
Mengapa setiap sumber ketidakpastian perlu dikaitkan dengan distribusi probabilitas?
Karena dalam uncertainty budget, kita tidak cukup hanya menuliskan:
- resolusi = 0,01 g
- repeatability = 0,02 g
- sertifikat = 0,10 g
- temperatur = ±1 °C
Semua angka tersebut mempunyai karakteristik yang berbeda.
Misalnya:
Repeatability = 0,02 g
Angka tersebut berasal dari sekumpulan hasil pengukuran. Kita dapat menghitung standard deviation.
Sedangkan:
Resolusi timbangan = 0,01 g
bukan hasil dari sekumpulan pengukuran. Nilai tersebut merupakan informasi mengenai kemampuan display instrumen.
Kemudian:
Sertifikat kalibrasi U = 0,10 g, k = 2
memberikan informasi yang berbeda lagi. Nilai 0,10 g merupakan expanded uncertainty dan harus dikonversi menggunakan coverage factor untuk mendapatkan standard uncertainty.
Sementara itu:
Temperatur = ±1 °C
mungkin berasal dari spesifikasi atau pengetahuan mengenai kondisi lingkungan. Kita mungkin tidak mempunyai data statistik yang cukup.
Karena karakteristiknya berbeda, cara mengubahnya menjadi standard uncertainty juga dapat berbeda.
3. Tujuan Akhirnya Adalah Standard Uncertainty
Dalam uncertainty budget, berbagai sumber ketidakpastian akhirnya perlu dinyatakan dalam bentuk yang dapat dibandingkan dan dikombinasikan.
Bentuk tersebut adalah:
standard uncertainty, u
Secara sederhana:
Standard uncertainty adalah cara menyatakan ketidakpastian dalam satu bentuk standar yang memungkinkan berbagai sumber ketidakpastian digabungkan.
Misalnya kita mempunyai:
| Sumber | Standard uncertainty |
|---|---|
| Repeatability | 0,020 g |
| Resolusi | 0,003 g |
| Kalibrasi | 0,050 g |
| Temperatur | 0,010 g |
Setelah semuanya menjadi standard uncertainty, kita dapat menggabungkannya menggunakan root sum of squares (RSS), jika kondisi dan asumsi korelasi yang digunakan memang memungkinkan:
u_c = √(u₁² + u₂² + u₃² + …)
Inilah salah satu alasan mengapa pemilihan distribusi probabilitas tidak boleh dilakukan sembarangan.
4. Distribusi Probabilitas yang Sering Digunakan
Dalam praktik evaluasi ketidakpastian, kita akan sering bertemu dengan beberapa distribusi berikut:
- Normal / Gaussian Distribution
- Rectangular / Uniform Distribution
- Triangular Distribution
- U-Shaped Distribution
- Log-Normal Distribution
- Rayleigh Distribution
Masing-masing mempunyai karakteristik yang berbeda.
Namun jangan berpikir bahwa setiap sumber ketidakpastian otomatis mempunyai satu distribusi tertentu.
Yang benar adalah:
Distribusi dipilih berdasarkan informasi atau model yang kita miliki mengenai sumber ketidakpastian tersebut.
Jadi, bukan:
“Ini resolusi, berarti pasti rectangular.”
Tetapi:
“Informasi yang kita miliki mengenai kesalahan akibat resolusi adalah seperti ini. Model probabilitas apa yang paling sesuai?”
Ini adalah cara berpikir yang lebih tepat.
A. Normal Distribution
Distribusi normal merupakan salah satu distribusi yang paling dikenal dalam statistik.
Bentuknya menyerupai lonceng:
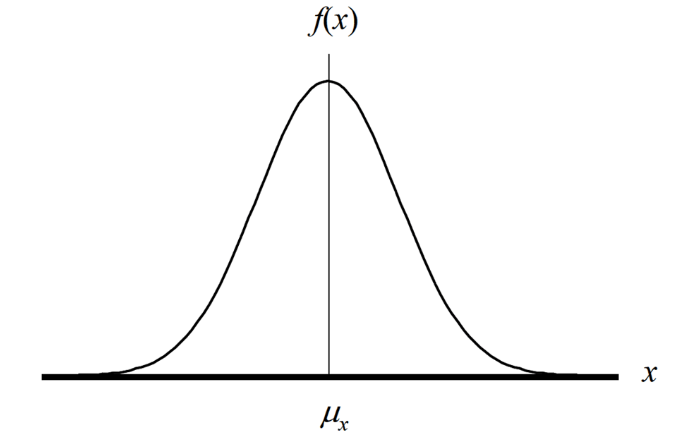
Nilai yang berada di sekitar mean mempunyai kemungkinan lebih besar dibandingkan nilai yang jauh dari mean.
Distribusi ini bersifat simetris.
Contohnya adalah hasil pengukuran berulang.
Misalnya sebuah benda ditimbang sebanyak 20 kali:
100,01
100,00
100,02
99,99
100,01
100,00
…
Jika proses pengukuran relatif stabil, hasil pengukuran biasanya berkumpul di sekitar nilai rata-rata.
Kita dapat menghitung:
- mean
- standard deviation
Standard deviation tersebut dapat digunakan sebagai standard uncertainty untuk komponen Type A tertentu, misalnya repeatability.
A.1. Mengapa Repeatability Sering Menggunakan Distribusi Normal?
Misalnya kita melakukan pengukuran sebanyak 20 kali dan mendapatkan standard deviation:
s = 0,01 g
Jika yang kita evaluasi adalah ketidakpastian dari hasil pengukuran tunggal, standard deviation tersebut dapat menjadi standard uncertainty:
u = s = 0,01 g
Tidak perlu membagi lagi dengan √3 atau √6 karena nilai tersebut sudah merupakan standard deviation.
Ini penting.
Pembagian dengan √3 atau √6 bukan aturan umum untuk semua ketidakpastian.
Pembagian tersebut digunakan ketika kita memulai dari informasi tertentu yang belum berbentuk standard deviation dan kemudian menggunakan model distribusi tertentu.
A.2. Expanded Uncertainty dan Coverage Factor
Misalnya sertifikat kalibrasi menyatakan:
U = 1 mg, k = 2
Artinya expanded uncertainty adalah 1 mg dengan coverage factor 2.
Untuk mendapatkan standard uncertainty:
u = U / k
sehingga:
u = 1 / 2 = 0,5 mg
Jadi:
Expanded uncertainty = 1 mg
sedangkan:
Standard uncertainty = 0,5 mg
Ini merupakan contoh yang sangat berbeda dari distribusi rectangular.
Jangan mencampur kedua konsep tersebut.
B. Rectangular Distribution
Rectangular distribution atau uniform distribution digunakan ketika semua nilai dalam suatu interval dianggap mempunyai kemungkinan yang sama.
Bentuk sederhananya:
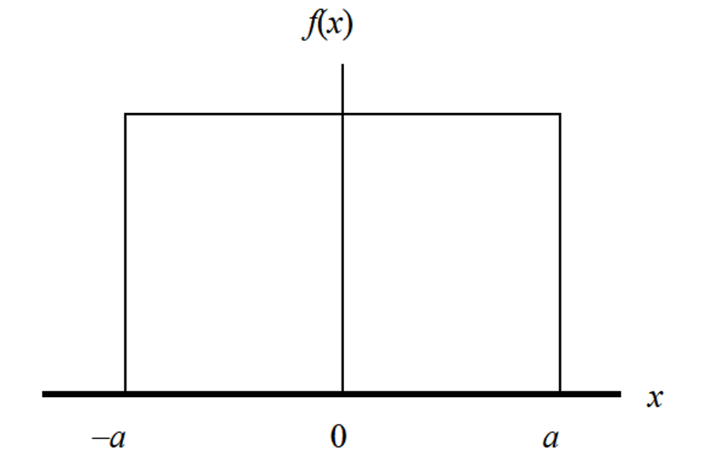
Misalnya kita mengetahui bahwa kesalahan berada antara:
−a sampai +a
dan tidak mempunyai alasan untuk mengatakan bahwa nilai tertentu lebih mungkin daripada nilai lainnya.
Maka rectangular distribution dapat digunakan.
Standard uncertainty-nya:
u = a / √3
B.1. Mengapa Ada √3?
Ini sering menjadi pertanyaan.
Jika distribusi uniform berada pada interval:
−a sampai +a
standard deviation dari distribusi tersebut adalah:
σ = a / √3
Karena standard uncertainty pada model tersebut adalah standard deviation-nya, maka:
u = a / √3
Jadi √3 bukan angka yang dipilih secara sembarangan.
Angka tersebut berasal dari karakteristik matematis distribusi uniform.
B. 2. Hal Penting: Half-Width dan Full Width
Ini adalah salah satu sumber kesalahan yang sangat umum.
Misalnya intervalnya:
−1 sampai +1
Lebar totalnya adalah:
2
Tetapi jarak dari tengah ke batas adalah:
1
Nilai 1 disebut half-width.
Jika informasi yang diberikan adalah:
±1
maka:
a = 1
dan:
u = 1 / √3
Namun jika seseorang memberikan angka:
full width = 2
maka:
u = 2 / √12
Hasilnya sama.
Karena:
2 / √12 = 1 / √3
Jadi yang harus diperhatikan bukan sekadar angka yang diberikan, tetapi:
Angka tersebut menunjukkan half-width atau full width?
B.3. Studi Kasus: Resolusi Digital Multimeter
Misalnya sebuah digital multimeter mempunyai resolusi:
1 mV
Display dapat menunjukkan:
1.000 V
1.001 V
1.002 V
dan seterusnya.
Jika nilai sebenarnya berada di antara dua titik display, pembulatan dapat menghasilkan kesalahan sampai sekitar:
±0,5 mV
Jika kita menggunakan rectangular distribution, maka:
u = 0,5 / √3
atau:
u = 1 / √12
sehingga:
u ≈ 0,289 mV
Inilah alasan penting untuk memahami apa yang dimaksud dengan “resolusi”.
Kita tidak boleh langsung mengambil:
1 / √3
hanya karena resolusinya 1 mV.
Jika 1 mV merupakan step size penuh, maka ketidakpastian akibat pembulatan adalah ±0,5 mV.
C. Triangular Distribution
Triangular distribution mempunyai bentuk segitiga:
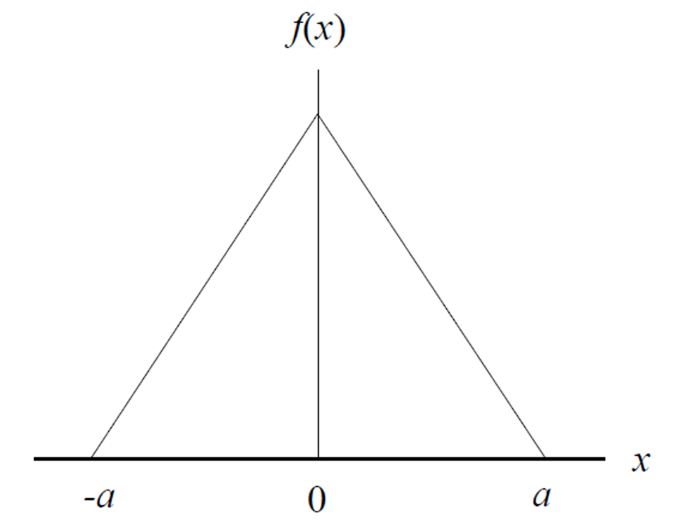
Berbeda dengan rectangular distribution.
Pada rectangular:
semua nilai dianggap sama mungkin.
Pada triangular:
nilai di sekitar titik tengah dianggap lebih mungkin dibandingkan nilai yang mendekati batas.
Untuk distribusi triangular simetris dengan batas:
−a sampai +a
dan puncak di tengah:
u = a / √6
C.1. Mengapa Memilih Triangular?
Pertanyaannya:
Kalau tidak mempunyai data, bagaimana kita tahu bahwa nilai tengah lebih mungkin?
Jawabannya:
Kita tidak “tahu” secara statistik.
Kita membuat model berdasarkan pengetahuan yang tersedia.
Misalnya berdasarkan:
- pengalaman proses,
- karakteristik alat,
- informasi teknis,
- spesifikasi,
- kondisi operasi,
- pengalaman operator,
- pengetahuan fisik terhadap proses.
Jadi triangular distribution merupakan sebuah assumption/model, bukan hasil pengukuran otomatis.
Asumsi tersebut harus masuk akal dan dapat dipertanggungjawabkan.
C.2. Studi Kasus: Dimensi Komponen
Misalnya sebuah komponen diproduksi dengan target:
10,00 mm
Berdasarkan pengalaman proses, operator mengetahui bahwa hasil biasanya berada dekat 10,00 mm.
Nilai yang sangat dekat dengan batas toleransi jarang terjadi.
Jika informasi tersebut memang dapat dipertanggungjawabkan, triangular distribution dapat menjadi salah satu model yang dipertimbangkan.
Misalnya batas:
9,99 mm sampai 10,01 mm
Maka half-width:
a = 0,01 mm
Jika menggunakan triangular distribution:
u = 0,01 / √6
sehingga:
u ≈ 0,00408 mm
Namun perlu ditekankan:
Tidak berarti setiap toleransi ±0,01 mm otomatis harus menggunakan triangular distribution.
Distribusi harus didukung oleh informasi yang kita miliki.
C.3. MPE Bukan Otomatis Uncertainty
Ini juga sangat penting dalam kalibrasi.
Misalnya spesifikasi alat menyatakan:
MPE = ±1 mg
MPE atau Maximum Permissible Error adalah batas kesalahan yang diizinkan berdasarkan suatu spesifikasi atau regulasi.
MPE bukan otomatis berarti:
U = 1 mg
dan bukan otomatis berarti standard uncertainty = 1 mg.
Jika kita ingin menggunakan ±1 mg sebagai batas distribusi, kita perlu menentukan model probabilitas yang sesuai.
Misalnya jika kita mempunyai alasan menggunakan rectangular:
u = 1 / √3 = 0,577 mg
Jika triangular:
u = 1 / √6 = 0,408 mg
Hasilnya berbeda.
Karena itu:
Pemilihan distribusi mempunyai pengaruh langsung terhadap uncertainty budget.
D. U-Shaped Distribution
U-shaped distribution mempunyai karakteristik yang berlawanan dengan triangular.
Pada triangular:
tengah paling mungkin.
Pada U-shaped:
bagian ekstrem lebih mungkin.
Gambaran sederhananya:
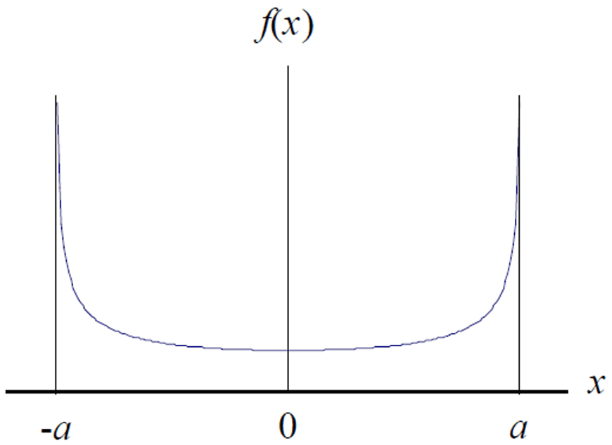
Nilai yang mendekati batas mempunyai probabilitas lebih besar dibandingkan nilai di tengah.
Untuk model U-shaped simetris tertentu:
u = a / √2
D.1. Studi Kasus: Thermostat Laboratorium
Bayangkan sebuah laboratorium menggunakan thermostat dengan setting:
20 °C
Thermostat mempunyai rentang kontrol:
19 °C sampai 21 °C
Sistem HVAC mungkin bekerja seperti ini:
- temperatur turun mendekati 19 °C → heater/HVAC aktif
- temperatur naik mendekati 21 °C → sistem berhenti atau berpindah kondisi
- temperatur kemudian bergerak kembali
Akibat mekanisme ON/OFF tersebut, temperatur dapat lebih sering berada dekat titik batas dibandingkan tepat pada titik tengah.
Dalam kondisi tertentu, perilaku tersebut dapat digambarkan dengan U-shaped distribution.
Namun dalam praktik uncertainty budget lingkungan, kita tidak boleh langsung menyimpulkan:
“Temperatur = U-shaped.”
Jika informasi yang tersedia tidak cukup untuk menunjukkan perilaku tersebut, rectangular atau triangular mungkin lebih sesuai.
Sekali lagi:
Distribusi harus mengikuti informasi yang tersedia, bukan sekadar mengikuti nama sumber ketidakpastian.
D.2. U-Shaped pada Pengukuran RF/Microwave
Contoh lain yang sering dijelaskan dalam pengukuran RF dan microwave adalah mismatch uncertainty.
Dalam sistem RF, terdapat impedansi sumber, kabel, konektor, dan sensor.
Ketidaksesuaian impedansi dapat menyebabkan sebagian energi dipantulkan.
Fenomena refleksi tersebut dapat menghasilkan karakteristik ketidakpastian yang tidak selalu cocok dengan rectangular atau triangular sederhana.
Karena itu, dalam aplikasi RF/microwave, model probabilitas khusus seperti U-shaped dapat digunakan untuk komponen tertentu.
Tetapi model tersebut sebaiknya mengikuti model pengukuran dan referensi teknis yang relevan.
Perbandingan Tiga Distribusi Utama
| Distribusi | Nilai yang paling mungkin | Rumus standard uncertainty |
|---|---|---|
| Normal | Di sekitar mean | berdasarkan standard deviation |
| Rectangular | Semua nilai sama mungkin | a / √3 |
| Triangular | Di sekitar tengah | a / √6 |
| U-shaped | Mendekati ekstrem | a / √2 |
Perhatikan bahwa:
1 / √2 > 1 / √3 > 1 / √6
Artinya, untuk nilai batas a yang sama, standard uncertainty yang dihasilkan berbeda.
Misalnya:
a = 1
Rectangular:
u = 0,577
Triangular:
u = 0,408
U-shaped:
u = 0,707
Hal ini menunjukkan bahwa pemilihan distribusi bukan sekadar formalitas.
5. Studi Kasus: Pressure Gauge Analog 500 Pa
Sekarang kita masuk ke contoh yang lebih dekat dengan pekerjaan kalibrasi.
Misalnya kita mempunyai differential pressure gauge analog dengan range:
0–500 Pa
Scale interval:
10 Pa
Artinya jarak antara dua garis skala adalah:
10 Pa
Pertanyaannya:
Berapa uncertainty akibat kemampuan membaca skala?
Jawabannya tidak otomatis:
10 / √3
Karena kita perlu menentukan terlebih dahulu seberapa jauh operator dapat membaca atau melakukan interpolasi posisi pointer.
A. Jika Hanya Bisa Membaca Setengah Divisi
Jika kita menganggap keterbatasan pembacaan adalah ±½ divisi:
a = 10 / 2 = 5 Pa
Jika menggunakan rectangular distribution:
u = 5 / √3
sehingga:
u ≈ 2,89 Pa
Jika menggunakan triangular distribution:
u = 5 / √6
sehingga:
u ≈ 2,04 Pa
Tetapi angka tersebut bukan “kebenaran universal”.
Kita masih harus mempertimbangkan karakteristik gauge dan cara pembacaan sebenarnya.
B. Bagaimana Jika Pointer Dapat Diinterpolasi Sampai Seperempat Divisi?
Misalnya scale interval 10 Pa sangat jelas dan operator dapat memperkirakan posisi pointer dengan cukup baik sampai seperempat divisi.
Maka secara konseptual:
a = 10 / 4 = 2,5 Pa
Jika digunakan triangular distribution:
u = 2,5 / √6
sehingga:
u ≈ 1,02 Pa
Namun ini harus didukung oleh prosedur atau bukti bahwa pembacaan seperempat divisi memang dapat dilakukan secara konsisten.
Jangan hanya memilih seperempat divisi karena hasil uncertainty menjadi lebih kecil.
Itu akan membalik logika uncertainty.
Yang benar:
Kemampuan pembacaan ditentukan terlebih dahulu berdasarkan karakteristik alat dan metode pembacaan; kemudian model distribusi dan standard uncertainty ditentukan.
6. Jangan Memilih Distribusi Berdasarkan Hasil yang “Lebih Bagus”
Ini merupakan jebakan yang sering terjadi.
Misalnya kita mempunyai batas:
±1
Kemudian kita menghitung:
Rectangular:
u = 0,577
Triangular:
u = 0,408
Kita mungkin tergoda mengatakan:
“Pakai triangular saja karena uncertainty lebih kecil.”
Ini tidak benar.
Pemilihan distribusi bukan kompetisi untuk mencari uncertainty terkecil.
Distribusi harus mencerminkan pengetahuan mengenai sumber ketidakpastian.
Jika kita tidak mempunyai alasan bahwa nilai tengah lebih mungkin, triangular tidak boleh dipilih hanya untuk mengecilkan angka uncertainty.
7. Type A dan Type B
Distribusi probabilitas juga berkaitan dengan Type A dan Type B.
Type A menggunakan evaluasi statistik dari pengamatan berulang.
Contohnya:
- repeatability,
- variasi hasil pengukuran,
- standard deviation.
Sedangkan Type B menggunakan informasi selain statistik pengamatan berulang secara langsung.
Contohnya:
- sertifikat kalibrasi,
- spesifikasi pabrikan,
- resolusi,
- data referensi,
- pengalaman,
- informasi teknis,
- batas toleransi,
- kondisi lingkungan.
Tetapi Type B bukan berarti “asal menebak”.
Type B tetap membutuhkan dasar yang rasional.
8. Contoh Uncertainty Budget Sederhana
Misalnya kita mengkalibrasi timbangan.
Hasil uncertainty budget:
| Sumber | Informasi | Distribusi | Standard uncertainty |
|---|---|---|---|
| Repeatability | s = 0,020 g | Normal | 0,020 g |
| Sertifikat | U = 0,050 g, k = 2 | Normal | 0,025 g |
| Resolusi | 0,01 g | Rectangular | 0,00289 g |
| Temperatur | ±0,10 g | Rectangular | 0,0577 g |
Kemudian kita dapat menghitung combined standard uncertainty:
u_c = √(0,020² + 0,025² + 0,00289² + 0,0577²)
Dari sini kita dapat melihat bahwa setiap sumber telah diubah menjadi bentuk yang sama.
Barulah semuanya dapat dikombinasikan.
Jika kita sederhanakan seluruh proses:
A. Langkah 1 — Identifikasi sumber ketidakpastian
Contoh:
resolusi
B. Langkah 2 — Tentukan informasi yang tersedia
Misalnya:
resolusi = 0,01 g
C. Langkah 3 — Tentukan model kesalahan
Misalnya:
±0,005 g
D. Langkah 4 — Pilih distribusi yang sesuai
Misalnya:
rectangular
E. Langkah 5 — Konversi menjadi standard uncertainty
u = 0,005 / √3
F. Langkah 6 — Masukkan ke uncertainty budget
Dengan demikian distribusi probabilitas berfungsi sebagai jembatan antara informasi awal dengan standard uncertainty.
9. Mengapa Kita Tidak Langsung Menjumlahkan Semua Ketidakpastian?
Misalnya:
- repeatability = 0,02 g
- calibration = 0,05 g
- resolution = 0,003 g
Mengapa tidak:
0,02 + 0,05 + 0,003 = 0,073 g
Karena ketiga sumber tersebut tidak selalu bekerja secara maksimum dalam arah yang sama secara bersamaan.
Dalam model penggabungan standar, kita biasanya menggunakan RSS:
u_c = √(u₁² + u₂² + u₃² + …)
sehingga:
u_c = √(0,02² + 0,05² + 0,003²)
Hasilnya lebih kecil daripada penjumlahan linear.
Namun ini bukan berarti RSS selalu boleh digunakan tanpa syarat. Korelasi antara input quantities perlu diperhatikan jika ada.
10. Bagaimana Jika Kita Tidak Mengetahui Distribusinya?
Ini situasi yang sangat umum.
Misalnya kita hanya mengetahui:
temperatur ruangan berubah ±2 °C
tetapi tidak mempunyai data temperatur lengkap.
Kita tidak boleh mengatakan:
“Karena tidak tahu, berarti normal.”
Distribusi normal bukan distribusi default untuk semua hal.
Kita perlu melihat informasi yang tersedia.
Jika semua nilai antara −2 °C dan +2 °C dianggap sama mungkin, rectangular dapat menjadi model yang masuk akal:
u = 2 / √3
Jika kita mempunyai alasan bahwa temperatur lebih sering berada di sekitar tengah, triangular dapat dipertimbangkan:
u = 2 / √6
Jika sistem kontrol membuat temperatur lebih sering berada di dekat batas, U-shaped mungkin relevan:
u = 2 / √2
Jadi:
Ketidaktahuan mengenai data tidak berarti kita bebas memilih distribusi apa saja. Kita harus menggunakan model yang paling dapat dipertanggungjawabkan berdasarkan informasi yang tersedia.
11. Histogram Sebagai Alat Bantu
Jika kita mempunyai data pengukuran, histogram sangat membantu.
Misalnya kita mempunyai 100 hasil temperatur:
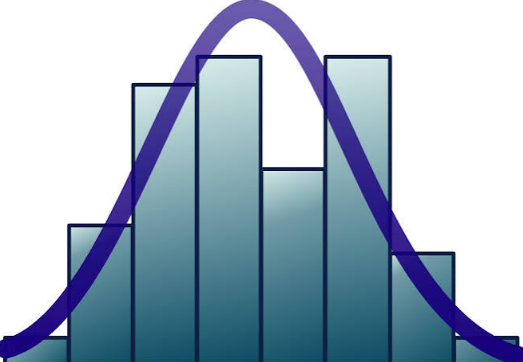
Jika bentuknya menyerupai lonceng dan simetris, distribusi normal mungkin sesuai.
Jika batang relatif sama tinggi:
distribusi uniform mungkin lebih cocok.
Jika data banyak terkumpul di tengah:
karakteristik triangular mungkin lebih mendekati.
Jika data banyak di kedua ujung:
karakteristik U-shaped mungkin terlihat.
Histogram tidak otomatis menentukan distribusi, tetapi dapat membantu kita memahami perilaku data.
12. Kesalahan yang Sering Terjadi
Ada beberapa kesalahan yang sering terjadi ketika orang mulai membuat uncertainty budget.
- Kesalahan 1: Semua ketidakpastian dibagi √3
Ini tidak benar.
√3 merupakan karakteristik rectangular distribution.
- Kesalahan 2: Semua Type B menggunakan rectangular
Juga tidak selalu benar.
Type B dapat menggunakan berbagai distribusi tergantung informasi yang tersedia.
- Kesalahan 3: Semua MPE dianggap uncertainty
Tidak otomatis.
MPE merupakan batas kesalahan yang diizinkan.
Jika digunakan sebagai input uncertainty, kita perlu membangun model yang sesuai.
- Kesalahan 4: Resolusi langsung dibagi √3
Tidak selalu.
Jika resolusi 1 unit berarti interval pembulatan penuh, kesalahan pembulatan umumnya ±½ unit.
Maka:
u = (R / 2) / √3
atau:
u = R / √12
jika rectangular digunakan.
- Kesalahan 5: Triangular dipilih karena hasilnya lebih kecil
Ini merupakan pendekatan yang salah.
Distribusi harus dipilih berdasarkan pengetahuan mengenai perilaku sumber ketidakpastian.
- Kesalahan 6: Menganggap U selalu expanded uncertainty
Simbol U dapat digunakan dalam konteks yang berbeda.
Dalam GUM, expanded uncertainty biasanya ditulis sebagai U, sedangkan standard uncertainty sebagai u.
Tetapi dalam suatu artikel atau tabel tertentu, simbol Uᵢ dapat saja digunakan untuk menyatakan batas atau half-width.
Karena itu, jangan hanya melihat simbol.
Lihat definisinya.
13. Cara Praktis Memilih Distribusi
Ketika membuat uncertainty budget, kita dapat menggunakan pertanyaan berikut.
- Pertanyaan 1
Apakah saya mempunyai data pengukuran berulang?
Jika ya, pertimbangkan evaluasi Type A dan distribusi berdasarkan data.
- Pertanyaan 2
Apakah saya hanya mempunyai batas atas dan bawah?
Jika semua nilai dianggap sama mungkin, rectangular dapat digunakan.
- Pertanyaan 3
Apakah saya mempunyai alasan bahwa nilai tengah lebih mungkin?
Triangular dapat dipertimbangkan.
- Pertanyaan 4
Apakah nilai ekstrem justru lebih mungkin?
U-shaped dapat dipertimbangkan.
- Pertanyaan 5
Apakah sumber ketidakpastian berasal dari sertifikat?
Periksa nilai uncertainty dan coverage factor yang diberikan.
- Pertanyaan 6
Apakah sumbernya resolusi?
Tentukan terlebih dahulu arti resolusi dan batas kesalahan pembulatannya.
- Pertanyaan 7
Apakah sumbernya MPE?
Jangan langsung menyebut MPE sebagai uncertainty. Tentukan model probabilitasnya berdasarkan informasi yang tersedia.
14. Studi Kasus Lengkap: Kalibrasi Pressure Gauge
Misalnya dalam pekerjaan kalibrasi pressure gauge mempunyai:
Range: 0–500 Pa
Scale interval: 10 Pa
Pada saat kalibrasi, kita juga mempunyai hasil repeatability:
s = 1,5 Pa
Sertifikat reference standard memberikan:
U = 2,0 Pa, k = 2
- Komponen 1: Repeatability
Karena standard deviation sudah diketahui:
u₁ = 1,5 Pa
- Komponen 2: Reference standard
u₂ = 2,0 / 2
sehingga:
u₂ = 1,0 Pa
- Komponen 3: Reading resolution
Jika diasumsikan keterbatasan pembacaan adalah ±½ scale division:
a = 5 Pa
Jika model rectangular:
u₃ = 5 / √3
sehingga:
u₃ ≈ 2,89 Pa
Maka uncertainty budget sederhananya:
| Komponen | Distribusi | Standard uncertainty |
|---|---|---|
| Repeatability | Normal | 1,50 Pa |
| Reference standard | Normal | 1,00 Pa |
| Reading | Rectangular | 2,89 Pa |
Kemudian:
u_c = √(1,5² + 1,0² + 2,89²)
Terlihat bahwa komponen reading memberikan kontribusi yang cukup besar.
Ini memberikan insight penting:
Uncertainty budget bukan hanya formalitas untuk mendapatkan satu angka.
Ia juga dapat menunjukkan sumber mana yang paling dominan.
15. Apa Pelajaran Terpenting dari Distribusi Probabilitas?
Setelah membahas berbagai distribusi, sebenarnya inti pembelajarannya dapat diringkas menjadi beberapa kalimat.
Pertama:
Distribusi probabilitas menggambarkan bagaimana kemungkinan suatu nilai tersebar.
Kedua:
Setiap sumber ketidakpastian perlu dimodelkan berdasarkan informasi yang tersedia.
Ketiga:
Tujuan akhirnya adalah mendapatkan standard uncertainty yang dapat digunakan secara konsisten dalam uncertainty budget.
Keempat:
Distribusi bukan dipilih untuk menghasilkan uncertainty yang paling kecil, tetapi untuk menggambarkan sumber ketidakpastian secara masuk akal.
Kelima:
Kita harus memahami apa arti angka yang digunakan sebelum memilih divisor.
Misalnya:
±1
berbeda dengan:
full width = 2
dan berbeda lagi dengan:
U = 1, k = 2
Ketiganya tidak boleh diperlakukan sama.
16. Ringkasan Rumus Penting
Untuk referensi cepat:
- Normal
Jika standard deviation sudah diketahui:
u = standar deviasi
Jika expanded uncertainty diberikan:
u = U / k
- Rectangular
Untuk batas:
−a ≤ x ≤ +a
maka:
u = a / √3
Jika yang diberikan adalah full width 2a:
u = 2a / √12
- Triangular
Untuk triangular simetris dengan batas ±a:
u = a / √6
- U-Shaped
Untuk model U-shaped simetris tertentu dengan batas ±a:
u = a / √2
Yang paling penting bukan menghafalkan angka:
√3, √6, √2
tetapi memahami mengapa angka tersebut digunakan.
17. Penutup
Distribusi probabilitas pada awalnya memang terlihat seperti bagian statistik yang rumit.
Tetapi jika dilihat dari sudut pandang uncertainty budget, konsepnya sebenarnya cukup sederhana.
Kita mempunyai sebuah sumber ketidakpastian.
Kita bertanya:
“Apa yang saya ketahui mengenai sumber ini?”
Jika kita mempunyai data pengukuran berulang, kita dapat menggunakan informasi statistik tersebut.
Jika kita mempunyai batas atas dan bawah tetapi tidak mengetahui kecenderungan nilai di dalamnya, rectangular distribution dapat menjadi model.
Jika kita mempunyai alasan bahwa nilai tengah lebih mungkin, triangular distribution dapat dipertimbangkan.
Jika nilai ekstrem lebih sering terjadi, U-shaped distribution dapat relevan.
Jika informasi berasal dari sertifikat kalibrasi, kita perlu memahami coverage factor dan hubungan antara expanded uncertainty dengan standard uncertainty.
Jika informasi berasal dari resolusi instrumen, kita harus memahami arti resolusi dan bagaimana kesalahan pembulatan dimodelkan.
Dan jika informasi berasal dari MPE, kita harus berhati-hati karena MPE bukan otomatis uncertainty.
Pada akhirnya, distribusi probabilitas dapat dipandang sebagai bahasa matematika untuk menggambarkan apa yang kita ketahui dan apa yang belum kita ketahui mengenai suatu sumber ketidakpastian.
Itulah sebabnya pemilihan distribusi merupakan bagian penting dalam evaluasi ketidakpastian pengukuran.
Bukan karena kita harus menghafalkan banyak rumus, tetapi karena kita harus mampu menjawab satu pertanyaan sederhana:
“Mengapa saya memilih distribusi ini untuk sumber ketidakpastian tersebut?”
Jika kita mampu menjawab pertanyaan itu dengan dasar teknis yang jelas, maka uncertainty budget yang kita buat akan jauh lebih mudah dipahami, dijelaskan, dan dipertanggungjawabkan.
Cukup panjang ya artikelnya, jika teman-teman masih bingung dan ingin lebih memahami lebih jauh mengenai distribusi probabilitas silakan mengikuti trainingnya. Bisa langsung klik disini.
Referensi :
- https://www.ukas.com/wp-content/uploads/2023/05/M3003-The-expression-of-uncertainty-and-confidence-in-measurement.pdf
- https://www.isobudgets.com/
- Pelatihan Uncertainty dari konsultan ISO 17025 untuk laboratorium kalibrasi