
Familiar dengan gambar diatas?
Ya.. benar.. itu adalah gambar pengolahan / evaluasi ketidakpastian bentangan kalibrasi.
Banyak diantara kita, termasuk saya he he.. pada saat mengolah data kalibrasi selalu mengabaikan atau melewati atau tidak memperhatikan bagian perhitungan ketidakpastian bentangan, karena biasanya pada tabel tersebut langsung otomatis jadi ketika kita memasukkan / menginput data mentah.
Betul tidak?
Nah, ketika ada seorang auditor bertanya apa itu k (faktor cakupan), apa itu v (derajat bebas), apa itu c (koefisien sensitifitas), barulah kita bingung menjawabnya.
Nah di artikel ini kita akan belajar santai mengenai derajat bebas tersebut.
Artinya & Pentingnya Derajat Bebas (v)
Dalam perhitungan ketidakpastian pengukuran, ada satu istilah yang sering muncul tetapi cukup membingungkan bagi orang yang baru mempelajari metrologi ataupun mengolah data kalibrasi (terlebih jika kita belum pernah mengikuti pelatihan kalibrasi), yaitu derajat bebas atau degrees of freedom (ν).
Istilah ini biasanya muncul ketika kita membahas evaluasi ketidakpastian Tipe A, distribusi Student’s t, ketidakpastian Tipe B, serta perhitungan effective degrees of freedom dengan persamaan Welch-Satterthwaite.
Bagi yang baru belajar, beberapa pertanyaan sangat wajar muncul:
- Apa sebenarnya arti derajat bebas?
- Mengapa untuk data pengukuran berulang digunakan rumus ν = n – 1?
- Apakah ν menunjukkan tingkat kepercayaan dalam persen?
- Mengapa derajat bebas berhubungan dengan distribusi Student’s t?
- Mengapa pada ketidakpastian Tipe B bisa muncul nilai ν = 200, padahal kita tidak mempunyai 201 data pengukuran?
Pertanyaan-pertanyaan tersebut sebenarnya saling berhubungan.
Artikel ini mencoba menjelaskan konsep derajat bebas dari dasar, kemudian menghubungkannya dengan distribusi Student’s t, ketidakpastian Tipe A dan Tipe B, hingga akhirnya melihat bagaimana seluruh komponen ketidakpastian digabungkan menjadi effective degrees of freedom (ν eff).
Pengertian Derajat Bebas (v)
Secara sederhana, derajat bebas dapat dipahami sebagai jumlah informasi statistik yang masih bebas digunakan untuk memperkirakan suatu besaran statistik setelah memperhitungkan adanya batasan atau parameter yang sudah diestimasi.
Dalam kasus yang paling sederhana, misalnya kita mempunyai n hasil pengukuran dan ingin menghitung rata-ratanya.
Jika kita mempunyai 5 data:
10, 11, 12, 13, 14maka kita mempunyai:
n = 5Untuk menghitung simpangan baku sampel, derajat bebasnya adalah:
ν = n - 1sehingga:
ν = 5 - 1
ν = 4
Mengapa tidak 5?
Karena setelah rata-rata sampel ditentukan, kelima data tersebut tidak lagi semuanya dapat berubah secara bebas jika rata-ratanya harus tetap sama.
Misalnya rata-rata kelima data tersebut adalah:
x̄ = 12Deviasi terhadap rata-rata adalah:
-2, -1, 0, +1, +2Jika empat deviasi sudah diketahui, deviasi kelima sebenarnya sudah ditentukan agar jumlah seluruh deviasi terhadap rata-rata tetap nol.
Secara matematis:
Σ(xᵢ - x̄) = 0Inilah salah satu cara paling sederhana untuk memahami mengapa:
ν = n - 1
Mengapa derajat bebas penting dalam ketidakpastian pengukuran?
Derajat bebas menjadi penting karena dalam evaluasi ketidakpastian kita tidak hanya ingin mengetahui seberapa besar ketidakpastian, tetapi juga perlu mengetahui seberapa kuat informasi statistik yang mendasari estimasi tersebut.
Bayangkan dua orang melaporkan standar deviasi yang sama:
s = 0,10Orang pertama mendapatkannya dari:
n = 3 pengukuransehingga:
ν = 2Sedangkan orang kedua mendapatkannya dari:
n = 61 pengukuransehingga:
ν = 60Nilai standar deviasinya memang sama, tetapi informasi statistik yang mendasarinya berbeda.
Dengan hanya tiga data, estimasi simpangan baku masih sangat tidak stabil.
Dengan 61 data, estimasi tersebut secara statistik biasanya jauh lebih stabil.
Jadi, derajat bebas memberikan informasi mengenai seberapa banyak informasi statistik yang tersedia untuk mendukung estimasi varians atau standar ketidakpastian.
Derajat bebas bukan persentase kepercayaan
Ini adalah bagian yang sangat penting.
Kadang-kadang orang mengatakan bahwa:
“Derajat bebas menunjukkan confidence.”
Pernyataan tersebut perlu diperjelas agar tidak menimbulkan salah pengertian.
Derajat bebas bukan persentase confidence.
Misalnya:
ν = 2bukan berarti:
confidence = 2%Demikian pula:
ν = 200bukan berarti:
confidence = 200%Derajat bebas dan confidence level adalah dua hal yang berbeda.
Misalnya kita menetapkan coverage probability:
p = 95%Kemudian kita mengetahui derajat bebas:
ν = 2Maka kita menggunakan distribusi Student’s t untuk menentukan coverage factor yang sesuai.
Jika:
ν = 60kita juga dapat menggunakan coverage probability 95%.
Jadi coverage probability tetap 95%.
Yang berubah adalah nilai coverage factor k.
Dengan kata lain:
Derajat bebas tidak menentukan berapa persen confidence yang kita pilih. Derajat bebas memengaruhi coverage factor yang diperlukan untuk mencapai coverage probability yang telah dipilih.
Hubungan derajat bebas dengan distribusi Student’s t
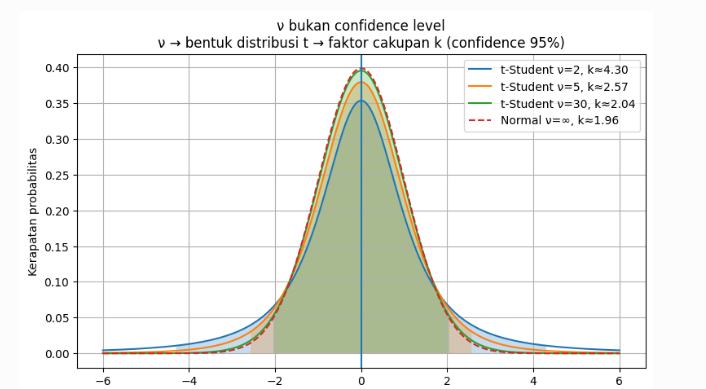
Gambar diatas mudah-mudahan dapat memberikan sedikit gambaran.
Di sinilah konsep derajat bebas menjadi semakin menarik.
Dalam kondisi tertentu, terutama ketika simpangan baku populasi tidak diketahui dan harus diperkirakan dari sampel, digunakan distribusi Student’s t.
Distribusi t mempunyai karakteristik yang berbeda-beda tergantung nilai derajat bebasnya.
Jika derajat bebas kecil, distribusi t mempunyai ekor yang lebih berat.
Jika derajat bebas semakin besar, distribusi t semakin mendekati distribusi normal.
Secara sederhana:
ν kecil
↓
informasi statistik lebih terbatas
↓
ketidakpastian estimasi varians lebih besar
↓
distribusi t memiliki ekor lebih berat
↓
coverage factor k lebih besar
Sebaliknya:
ν besar
↓
informasi statistik lebih banyak
↓
estimasi varians lebih stabil
↓
distribusi t mendekati normal
↓
coverage factor k semakin kecil
Mengapa derajat bebas kecil membuat ekor distribusi t lebih berat?
Hal ini dapat dipahami dari persamaan distribusi t:
t = Z / √(S²/σ²)Secara konsep, Z berkaitan dengan distribusi normal, sedangkan penyebut melibatkan estimasi simpangan baku dari sampel.
Jika jumlah data sedikit, estimasi varians atau simpangan baku sampel masih sangat tidak stabil.
Kadang-kadang estimasi tersebut bisa terlalu kecil.
Jika penyebut menjadi kecil, nilai t dapat menjadi sangat besar.
Akibatnya, peluang mendapatkan nilai yang jauh dari pusat menjadi lebih besar.
Inilah yang kita lihat sebagai heavy tails atau ekor distribusi yang lebih berat.
Karena luas total di bawah kurva probabilitas harus selalu sama dengan 1, ketika lebih banyak probabilitas berada di bagian ekor, tinggi bagian tengah kurva menjadi lebih rendah.
Jadi ketika dibandingkan:
ν = 2dengan:
ν = 60distribusi dengan ν = 2 mempunyai:
- puncak tengah yang lebih rendah,
- ekor yang lebih berat,
- peluang nilai ekstrem yang lebih besar.
Sedangkan ν = 60 lebih terkonsentrasi di sekitar nilai tengah dan bentuknya sudah mendekati distribusi normal.
Contoh ν = 2 dan ν = 60
Misalkan kita ingin mendapatkan coverage probability 95%.
Untuk:
ν = 2coverage factor Student’s t kira-kira:
k = 4,303Sedangkan untuk:
ν = 60nilai k kira-kira:
k = 2,000Perhatikan perbedaannya.
Coverage probability yang kita inginkan sama:
95%Tetapi coverage factor berbeda:
ν = 2   → k ≈ 4,303
ν = 60  → k ≈ 2,000
Artinya, ketika informasi statistik sangat terbatas, kita membutuhkan interval yang lebih lebar untuk memperoleh coverage probability yang sama.
Derajat bebas tidak hanya berkaitan dengan jumlah data
Pada ketidakpastian Tipe A, kita memang sering mendapatkan:
ν = n - 1Tetapi jangan menyimpulkan bahwa:
“Derajat bebas selalu sama dengan jumlah data dikurangi satu.”
Itu hanya berlaku pada kasus tertentu, misalnya estimasi varians dari sejumlah pengukuran berulang dengan satu parameter rata-rata yang diestimasi.
Dalam model yang lebih kompleks, beberapa parameter dapat diestimasi.
Misalnya dalam regresi, derajat bebas residual secara sederhana dapat berbentuk:
ν = n - pdengan:
n= jumlah observasip= jumlah parameter yang diestimasi
Jadi konsep yang lebih umum adalah:
Derajat bebas berkaitan dengan jumlah informasi yang masih bebas setelah memperhitungkan parameter atau batasan yang digunakan dalam proses estimasi.
Derajat bebas pada ketidakpastian Tipe A
Ketidakpastian Tipe A diperoleh dari analisis statistik terhadap serangkaian hasil pengukuran.
Misalnya sebuah timbangan digunakan untuk menimbang suatu anak timbangan sebanyak 10 kali.
Hasilnya:
100,02
100,01
100,03
100,02
100,00
100,01
100,02
100,03
100,01
100,02 g
Jumlah data:
n = 10Jika kita menghitung rata-rata:
x̄ = Σxᵢ / ndan simpangan baku sampel:
s = √[Σ(xᵢ - x̄)² / (n - 1)]maka derajat bebas:
ν = n - 1sehingga:
ν = 10 - 1
ν = 9
Standar ketidakpastian dari rata-rata adalah:
u(x̄) = s / √nJadi dalam kasus Tipe A sederhana, kita mendapatkan hubungan:
n
↓
s
↓
u(x̄)
↓
ν = n - 1
Mengapa yang digunakan adalah rata-rata, bukan simpangan baku?
Pertanyaan ini sering muncul.
Mengapa derajat bebas menjadi n - 1? Mengapa bukan karena kita menghitung simpangan baku?
Jawabannya berkaitan dengan parameter yang diestimasi.
Ketika kita mempunyai n data dan menggunakan data tersebut untuk memperkirakan rata-rata populasi, kita telah menggunakan satu parameter, yaitu rata-rata.
Setelah rata-rata ditentukan, deviasi terhadap rata-rata harus memenuhi:
Σ(xᵢ - x̄) = 0Artinya ada satu hubungan yang membatasi kebebasan data.
Karena satu kebebasan telah digunakan untuk mengestimasi rata-rata:
n - 1informasi bebas tersisa untuk mengestimasi varians.
Jadi bukan berarti “simpangan baku mempunyai derajat bebas sendiri karena simpangan baku”.
Lebih tepat dikatakan:
Ketika varians sampel dihitung setelah satu parameter, yaitu rata-rata, diestimasi dari data, maka terdapat
n - 1derajat bebas dalam kasus sederhana tersebut.
Bagaimana dengan ketidakpastian Tipe B?
Nah, ini yang kadang buat kita merasa bingung.
Ketidakpastian Tipe B tidak diperoleh dengan melakukan analisis statistik langsung terhadap serangkaian pengukuran berulang seperti Tipe A.
Menurut VIM (Vocabulary Measurement), evaluasi Tipe B dilakukan dengan cara selain evaluasi Tipe A.
Sumber informasinya dapat berupa:
- sertifikat kalibrasi,
- spesifikasi pabrikan,
- data referensi,
- kelas akurasi,
- resolusi alat,
- pengalaman sebelumnya,
- data drift,
- informasi dari manual,
- atau sumber informasi lain yang relevan.
Karena tidak selalu berasal dari sejumlah n pengukuran berulang, maka kita tidak bisa mengatakan:
ν = n - 1untuk semua komponen Tipe B.
Lalu bagaimana menentukan ν untuk Tipe B?
Dalam GUM (Guide Uncertainty Measurement), salah satu pendekatan yang dapat digunakan adalah memperkirakan seberapa besar ketidakpastian relatif dari nilai standar ketidakpastian itu sendiri.
Secara sederhana, GUM memberikan hubungan:
νᵢ ≈ 1/2 × [Δu(xᵢ) / u(xᵢ)]⁻²Keterangan:
νᵢ= derajat bebas komponen ke-iu(xᵢ)= standar ketidakpastian dari inputxᵢΔu(xᵢ)= ketidakpastian yang diperkirakan terdapat pada nilaiu(xᵢ)
Jika didefinisikan:
R = [Δu(xᵢ) / u(xᵢ)] × 100%maka persamaannya dapat ditulis:
νᵢ ≈ 1/2 × (100 / R)²Di sinilah sering terjadi salah pengertian.
Apa sebenarnya arti R?
Dalam beberapa materi pelatihan kalibrasi alat ukur, R kadang disebut sebagai reliability.
Misalnya dikatakan:
“Reliability 95% menghasilkan ν = 200.”
Namun secara lebih hati-hati, kita sebaiknya memahami R dalam persamaan tersebut sebagai relative uncertainty dari nilai standar ketidakpastian u(xᵢ).
Jadi apabila:
R = 5%artinya secara sederhana:
Nilai standar ketidakpastian
u(xᵢ)tersebut diperkirakan mempunyai ketidakpastian relatif sekitar 5%.
Ini bukan berarti sumber kesalahan fisik tersebut mempunyai error sebesar 5%.
Yang dinilai adalah seberapa yakin atau seberapa stabil kita dalam menetapkan nilai u(xᵢ) tersebut.
Contoh R = 5% menghasilkan ν = 200
Misalkan kita menilai bahwa nilai standar ketidakpastian suatu komponen diketahui dengan ketidakpastian relatif:
R = 5%Maka:
ν = 1/2 × (100 / 5)²atau:
ν = 1/2 × 20²sehingga:
ν = 1/2 × 400dan:
ν = 200Jadi diperoleh:
ν = 200Tetapi ν = 200 bukan berarti kita mempunyai 201 data pengukuran.
Ini sangat penting.
Pada Tipe B, angka tersebut merupakan derajat bebas ekuivalen yang digunakan untuk menggambarkan ketidakpastian statistik dari estimasi standar ketidakpastian.
Contoh beberapa nilai R
Hubungan tersebut dapat dilihat dari contoh berikut.
| Relative uncertainty R | Derajat bebas ν |
|---|---|
| 50% | 2 |
| 25% | 8 |
| 20% | 12,5 |
| 10% | 50 |
| 5% | 200 |
| 2% | 1.250 |
| 1% | 5.000 |
Dari tabel tersebut terlihat pola yang menarik.
Semakin kecil R, semakin besar ν.
Artinya, semakin kecil ketidakpastian relatif yang kita berikan terhadap nilai u(xᵢ), semakin besar derajat bebas yang dihasilkan.
Sebaliknya, jika kita merasa nilai u(xᵢ) masih sangat tidak pasti, maka ν menjadi kecil.
Mengapa R yang lebih kecil menghasilkan ν yang lebih besar?
Lihat kembali persamaan:
ν ≈ 1/2 × (100 / R)²Karena R berada di penyebut, ketika R mengecil, hasil pembagian menjadi semakin besar.
Misalnya:
R = 50%

ν = 1/2 × (100/50)²
ν = 2
Sedangkan:
R = 5%

ν = 1/2 × (100/5)²
ν = 200
Jadi:
R besar
↓
ketidakpastian terhadap u(xᵢ) besar
↓
ν kecil
sedangkan:
R kecil
↓
ketidakpastian terhadap u(xᵢ) kecil
↓
ν besar
Ini konsisten dengan makna statistik derajat bebas.
Bagaimana dengan distribusi rectangular?
Dalam evaluasi Tipe B, kita sering menggunakan distribusi probabilitas seperti:
- rectangular,
- triangular,
- normal,
- atau distribusi lainnya.
Misalnya sebuah spesifikasi menyatakan bahwa kesalahan suatu alat berada dalam rentang:
±aJika kita menganggap semua nilai di antara -a dan +a mempunyai peluang yang sama, kita dapat menggunakan distribusi rectangular.
Standar ketidakpastiannya adalah:
u = a / √3Namun jangan langsung mengatakan:
“Karena menggunakan distribusi rectangular, maka ν = 200.”
Pernyataan tersebut tidak benar secara umum.
Jika batas a diketahui dengan sangat baik dan dianggap tepat, maka GUM memperlakukan standar ketidakpastian tersebut sebagai diketahui secara eksak.
Dalam kondisi tersebut:
ν → ∞Artinya derajat bebasnya dianggap sangat besar.
Jadi:
Distribusi probabilitas dan derajat bebas adalah dua konsep yang berbeda.
Distribusi menentukan bentuk probabilitas dari input quantity.
Derajat bebas berkaitan dengan ketidakpastian statistik dalam estimasi varians atau standar ketidakpastian.
Contoh kasus: resolusi timbangan
Bagi teman-teman yang pernah mengikuti training kalibrasi timbangan tentu sangat paham hal ini.
Misalkan sebuah timbangan mempunyai resolusi:
d = 0,01 gJika kesalahan akibat resolusi dianggap mengikuti distribusi rectangular, salah satu pendekatan yang umum adalah menggunakan setengah interval:
a = d / 2sehingga:
a = 0,005 gKemudian standar ketidakpastian:
u = a / √3atau:
u = 0,005 / √3sehingga:
u ≈ 0,00289 gJika batas resolusi tersebut dianggap diketahui dengan sangat baik, maka komponen ini dapat diperlakukan sebagai mempunyai:
ν → ∞Tidak berarti kita melakukan pengukuran sebanyak tak terhingga kali.
Artinya, ketidakpastian statistik dari nilai standar ketidakpastian tersebut dianggap dapat diabaikan.
Contoh kasus: sertifikat kalibrasi
Sekarang bayangkan sebuah alat ukur telah dikalibrasi.
Sertifikat kalibrasi memberikan hasil:
Error = 0,12 g
Expanded uncertainty = 0,08 g
Coverage factor = 2
Jika sertifikat juga memberikan informasi mengenai derajat bebas, misalnya:
ν = 10maka informasi tersebut dapat digunakan dalam evaluasi ketidakpastian kita.
Hal ini berbeda dengan kasus di mana sebuah spesifikasi pabrikan hanya mengatakan:
Accuracy = ±0,1 gPada kasus kedua, kita perlu menentukan model probabilitas dan standar ketidakpastian berdasarkan informasi yang tersedia.
Derajat bebas tidak otomatis sama untuk semua sumber.
Setelah semua komponen dihitung, bagaimana menggabungkannya?
Dalam perhitungan ketidakpastian, kita biasanya mempunyai beberapa komponen.
Misalnya:
| Sumber ketidakpastian | u | ν |
|---|---|---|
| Repeatability | 0,08 | 4 |
| Calibration certificate | 0,06 | 200 |
| Resolution | 0,02 | ∞ |
Kita dapat menghitung combined standard uncertainty:
u_c = √(u₁² + u₂² + u₃² + ...)Dengan angka di atas:
u_c = √(0,08² + 0,06² + 0,02²)sehingga:
u_c = √(0,0064 + 0,0036 + 0,0004)atau:
u_c = √0,0104sehingga:
u_c ≈ 0,102 gTetapi kita belum selesai.
Kita masih perlu menentukan effective degrees of freedom.
Apa itu effective degrees of freedom?
Ketika beberapa komponen ketidakpastian mempunyai derajat bebas yang berbeda, kita membutuhkan satu nilai derajat bebas yang mewakili keseluruhan combined standard uncertainty.
Nilai tersebut disebut:
effective degrees of freedom
dan ditulis:
ν_effSalah satu persamaan yang digunakan adalah persamaan Welch-Satterthwaite:
ν_eff = u_c⁴ / Σ(uᵢ⁴ / νᵢ)Jika hanya ada tiga komponen:
ν_eff = u_c⁴/[(u₁⁴/ν₁) + (u₂⁴/ν₂) + (u₃⁴/ν₃)]Jika suatu komponen mempunyai:
ν = ∞maka secara matematis:
uᵢ⁴ / ∞ = 0sehingga komponen tersebut tidak memberikan kontribusi pada penyebut persamaan Welch-Satterthwaite.
Contoh menghitung ν_eff
Gunakan contoh yang lebih sederhana:
u₁ = 0,08
ν₁ = 4

u₂ = 0,06
ν₂ = 200
Combined standard uncertainty:
u_c = √(0,08² + 0,06²)sehingga:
u_c = √0,010atau:
u_c ≈ 0,10Kemudian:
ν_eff = 0,10⁴/[(0,08⁴/4) + (0,06⁴/200)]Hasilnya kira-kira:
ν_eff ≈ 10Perhatikan sesuatu yang menarik.
Kita mempunyai:
ν₁ = 4
ν₂ = 200
tetapi effective degrees of freedom hanya sekitar:
ν_eff ≈ 10Mengapa?
Karena kontribusi setiap sumber terhadap combined uncertainty berbeda.
Komponen yang mempunyai ketidakpastian relatif besar dapat memberikan pengaruh jauh lebih besar terhadap ν_eff.
Mengapa komponen dengan ν kecil bisa sangat berpengaruh?
Lihat kembali persamaan:
ν_eff = u_c⁴ / Σ(uᵢ⁴/νᵢ)Ada dua hal penting dalam penyebut:
uᵢ⁴dan:
νᵢJika uᵢ besar, nilai uᵢ⁴ dapat menjadi sangat besar.
Jika νᵢ kecil, pembagian dengan νᵢ juga menghasilkan nilai yang lebih besar.
Akibatnya, komponen dengan ketidakpastian besar dan derajat bebas kecil dapat mendominasi perhitungan ν_eff.
Inilah salah satu alasan mengapa tidak cukup hanya melihat nilai ketidakpastian.
Kita juga perlu memperhatikan derajat bebasnya.
Dari ν_eff menuju coverage factor
Setelah memperoleh:
ν_effkita dapat menentukan coverage factor k sesuai dengan coverage probability yang diinginkan dan asumsi distribusi yang digunakan.
Kemudian expanded uncertainty dihitung:
U = k × u_cMisalnya:
u_c = 0,10 gdan dari distribusi Student’s t diperoleh:
k = 2,23maka:
U = 2,23 × 0,10sehingga:
U = 0,223 gHasil pengukuran kemudian dapat dilaporkan, misalnya:
Hasil = 100,00 g ± 0,22 gdengan coverage probability sesuai dengan dasar pemilihan k.
Inilah hubungan seluruh konsepnya
Jika seluruh pembahasan tadi dirangkai, hubungan logisnya menjadi seperti ini:
Data / informasi pengukuran
        ↓
Evaluasi ketidakpastian
        ↓
Komponen Tipe A dan Tipe B
        ↓
Standard uncertainty uᵢ
        ↓
Degrees of freedom νᵢ
        ↓
Combined standard uncertainty u_c
        ↓
Welch-Satterthwaite
        ↓
Effective degrees of freedom ν_eff
        ↓
Coverage factor k
        ↓
Expanded uncertainty U
Dengan demikian, derajat bebas bukan sekadar angka yang dimasukkan ke dalam Excel.
Ia merupakan bagian dari rantai statistik yang menghubungkan informasi yang tersedia dengan ketidakpastian yang akhirnya kita laporkan.
Kesalahan Saya Dulu dalam Memahami Derajat Bebas
Ada beberapa kesalahpahaman yang cukup sering muncul ketika mempelajari derajat bebas.
- Kesalahan 1: ν adalah confidence level
Tidak benar.
ν ≠ confidence %Derajat bebas memengaruhi distribusi statistik dan coverage factor untuk coverage probability tertentu.
- Kesalahan 2: ν = jumlah data
Tidak selalu.
Pada kasus sederhana Tipe A:
ν = n - 1Tetapi pada Tipe B, ν dapat merupakan derajat bebas ekuivalen dan tidak berarti jumlah data.
- Kesalahan 3: ν = 200 berarti ada 201 data
Tidak.
Pada Tipe B, nilai:
ν = 200dapat berasal dari penilaian relative uncertainty terhadap nilai u(xᵢ).
Tidak ada keharusan bahwa kita mempunyai 201 pengukuran.
- Kesalahan 4: semua Tipe B mempunyai ν = ∞
Tidak selalu.
Jika standar ketidakpastian dianggap diketahui dengan sangat baik, ν dapat dianggap tak hingga.
Tetapi pada kondisi tertentu, Tipe B dapat mempunyai derajat bebas terbatas.
- Kesalahan 5: distribusi rectangular otomatis mempunyai ν = 200
Tidak benar.
Rectangular adalah bentuk distribusi probabilitas.
Derajat bebas adalah konsep yang berbeda.
Jika batas distribusi dianggap diketahui secara eksak:
ν → ∞- Kesalahan 6: ν besar berarti confidence lebih besar
Tidak tepat jika diartikan sebagai confidence level.
Lebih tepat mengatakan:
Derajat bebas yang besar menunjukkan bahwa estimasi varians atau standar ketidakpastian didukung oleh informasi statistik yang relatif lebih kuat atau lebih stabil.
Coverage probability tetap merupakan sesuatu yang kita tetapkan atau tentukan dalam proses evaluasi.
Jadi, apa sebenarnya fungsi derajat bebas?
Jika harus dijelaskan kepada seseorang yang baru belajar metrologi, saya akan menyederhanakannya seperti ini:
Derajat bebas adalah ukuran banyaknya informasi statistik yang tersedia untuk mendukung suatu estimasi, setelah memperhitungkan parameter atau batasan yang digunakan dalam proses estimasi.
Kemudian dalam konteks ketidakpastian pengukuran:
Derajat bebas digunakan untuk menggambarkan seberapa kuat informasi statistik yang mendukung suatu komponen ketidakpastian, dan selanjutnya digunakan untuk menentukan effective degrees of freedom serta coverage factor yang sesuai.
Jadi jangan melihat ν hanya sebagai angka.
Misalnya:
ν = 2memberi gambaran bahwa informasi statistik yang mendukung estimasi tersebut masih terbatas.
Sedangkan:
ν = 200menunjukkan bahwa estimasi tersebut secara statistik jauh lebih stabil, dalam konteks model yang menghasilkan nilai tersebut.
Rangkuman
Derajat bebas adalah salah satu konsep dasar tetapi sangat penting dalam evaluasi ketidakpastian pengukuran.
Pada evaluasi Tipe A sederhana:
ν = n - 1karena satu parameter, yaitu rata-rata, telah diestimasi dari data.
Derajat bebas kemudian berhubungan dengan distribusi Student’s t. Ketika ν kecil, distribusi t mempunyai ekor lebih berat sehingga coverage factor yang diperlukan untuk coverage probability tertentu menjadi lebih besar.
Sebaliknya, ketika ν semakin besar, distribusi t semakin mendekati distribusi normal.
Pada Tipe B, derajat bebas tidak berasal dari jumlah pengukuran berulang. Salah satu pendekatan GUM adalah menggunakan perkiraan relative uncertainty dari nilai standar ketidakpastian:
νᵢ ≈ 1/2 × [Δu(xᵢ) / u(xᵢ)]⁻²atau jika:
R = [Δu(xᵢ) / u(xᵢ)] × 100%maka:
νᵢ ≈ 1/2 × (100 / R)²Contohnya:
R = 5%menghasilkan:
ν = 200Namun:
ν = 200tidak berarti terdapat 201 data pengukuran.
Ketika beberapa komponen ketidakpastian digabungkan, masing-masing mempunyai derajat bebas yang berbeda. Oleh karena itu digunakan effective degrees of freedom, yang dapat dihitung menggunakan persamaan Welch-Satterthwaite:
ν_eff = u_c⁴ / Σ(uᵢ⁴ / νᵢ)Nilai ν_eff kemudian digunakan dalam penentuan coverage factor k, dan akhirnya:
U = k × u_cDengan memahami alur ini, derajat bebas tidak lagi terlihat sebagai angka yang tiba-tiba muncul di akhir perhitungan ketidakpastian.
Ia merupakan bagian dari perjalanan statistik:
informasi
→ ketidakpastian
→ derajat bebas
→ ν_eff
→ coverage factor
→ expanded uncertainty
Dan mungkin inilah cara paling sederhana untuk mengingat konsepnya:
Derajat bebas bukan ukuran confidence dalam persen. Derajat bebas adalah informasi statistik yang membantu kita mengetahui seberapa besar “cadangan informasi” yang kita miliki ketika memperkirakan ketidakpastian. Semakin terbatas informasi statistiknya, semakin besar kehati-hatian statistik yang diperlukan dalam menentukan coverage factor.